Context rot: perché Claude peggiora nelle chat lunghe (e perché dovresti smettere di allegare i file)
Il context rot è il calo di precisione di Claude man mano che il contesto si riempie. Quattro grafici e 231 sessioni di lavoro misurate: perché i modelli leggeri cedono prima, perché allegare i file peggiora le risposte, quando aprire una chat nuova e come organizzare progetti e memoria.
Il context rot è il calo di precisione di un modello AI man mano che il contesto si riempie: più testo ha davanti, peggio ritrova e usa l'informazione giusta. Lo dice Anthropic nella documentazione di Claude. Comincia molto prima del limite della finestra, cresce con le chat lunghe e con gli allegati pesanti, e una chat nuova lo azzera.
In pratica: apri una chat nuova quando cambi compito, dopo due correzioni che non bastano o quando compare la compattazione, e ai file dai il percorso invece di allegarli.
Sul campo lo vedo in due situazioni, sempre le stesse. La prima è la conversazione lunga: più si va avanti, più gli errori aumentano, a volte con allucinazioni importanti, e più ci si avvicina al massimo del contesto, più ne arrivano. Più il modello è leggero, prima succede. La seconda è l'allegato: un Excel o un PDF caricato in chat diventa token, occupa contesto e, quando la conversazione cresce, il modello ne perde dei pezzi. In questo articolo metto le due cose davanti ai numeri, con quattro grafici e una misura fatta sulle mie sessioni di lavoro.
Cos'è il context rot e perché Claude peggiora in una chat lunga?
Il nome viene dagli studi in cui si nasconde un'informazione dentro un testo lungo e si chiede al modello di ritrovarla. Anthropic lo definisce così nella pagina sulle finestre di contesto: più contesto non è automaticamente meglio, perché "as token count grows, accuracy and recall degrade, a phenomenon known as context rot". Nell'articolo sul context engineering del 29 settembre 2025 aggiunge l'immagine più utile per capirlo: i modelli hanno un "attention budget", un budget di attenzione, e ogni token nuovo ne consuma un po'.
In una chat il meccanismo è semplice. A ogni messaggio il modello rilegge tutta la conversazione: secondo la stessa documentazione, l'input contiene "all previous conversation history plus the current user message". Ogni bozza scartata, ogni tentativo sbagliato e ogni correzione restano lì, e vengono riletti ogni volta.
E non sono rumore neutro. Lo studio di Chroma del 14 luglio 2025 su 18 modelli, che racconto anche nell'articolo sulle skill che uso ogni giorno, ha misurato che basta un solo distrattore, cioè un'informazione simile a quella giusta ma sbagliata, per abbassare la resa. In una chat lunga i distrattori sono le tue versioni precedenti. Una parte delle allucinazioni che sembrano inspiegabili può venire da qui: una versione vecchia, ancora nel contesto, che somiglia a quella giusta.
Il context rot c'è ancora con i modelli nuovi?
Sì, ma molto meno di due anni fa, e la differenza conta per capire cosa fare.
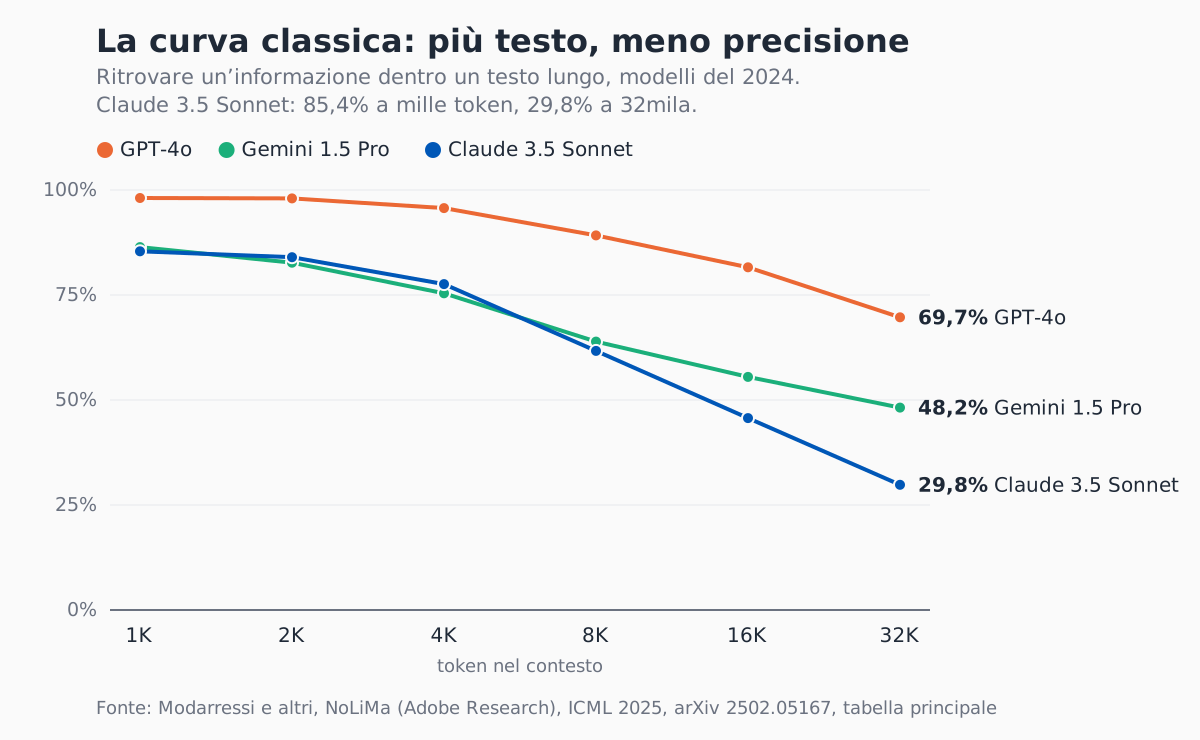
La curva che ha reso famoso il problema è quella di NoLiMa, lo studio di Adobe Research presentato a ICML 2025: a 32mila token, 11 modelli su 13 scendevano alla metà o meno del loro punteggio su un testo corto. Claude 3.5 Sonnet, per esempio, passa dall'85,4% a mille token al 29,8% a 32mila.
Quei modelli però sono del 2024. Su Fiction.LiveBench, una prova di comprensione profonda di storie lunghe aggiornata al 4 aprile 2026, i modelli recenti tengono molto meglio: Claude Opus 4.6 è al 93,8% a 120mila token, GPT-5.2 e Gemini 3 Pro restano sopra il 96%. Il campione è piccolo e i valori salgono e scendono a scatti, ma il segnale è chiaro: fino a 120mila token i modelli di fascia alta non crollano più.
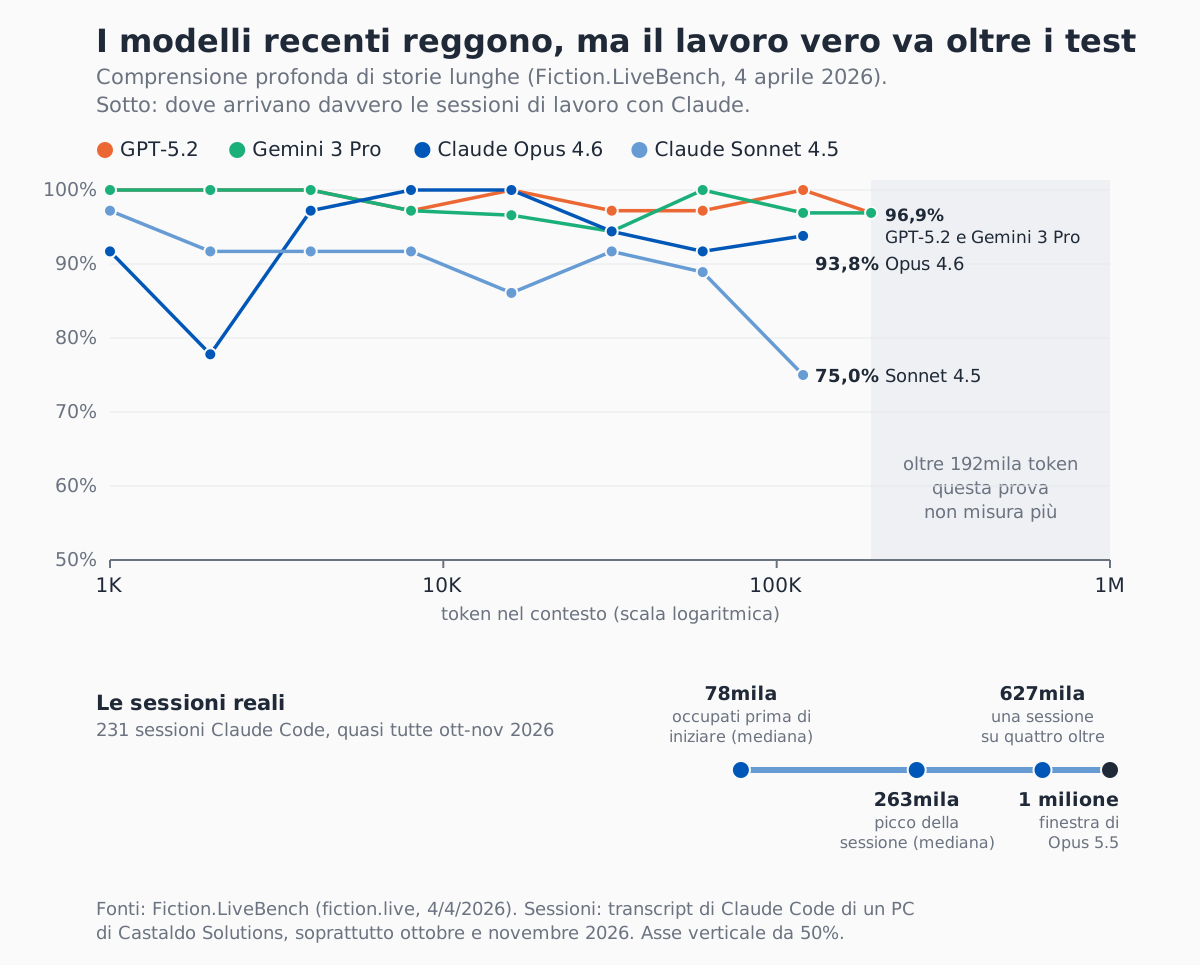
Il punto è dove finiscono i test. Ho misurato le 231 sessioni di Claude Code registrate su uno dei miei PC negli ultimi tre mesi, quasi tutte di ottobre e novembre 2026 e quasi tutte con Opus 5.5:
- prima ancora del primo messaggio, il contesto è già occupato per 78mila token (mediana): istruzioni, regole, memoria, strumenti;
- metà delle sessioni arriva oltre i 263mila token, una su quattro oltre i 627mila;
- 31 sessioni su 231 sono arrivate alla compattazione automatica.
La misura viene dai transcript locali di Claude Code, che per ogni risposta registrano quanti token il modello aveva in ingresso. È un solo PC e un solo utente: descrive il mio modo di lavorare, non una media.
Il lavoro vero, quindi, si fa proprio nella zona in cui le curve pubbliche non arrivano. Per Opus 5.5 Anthropic non pubblica una curva per lunghezza: nella system card del 22 settembre 2026 misura il contesto lungo con ProgramBench, un compito di programmazione che arriva fino a un milione di token, dove Opus 5.5 fa il 91,2%. Il confronto diretto più recente che ho trovato a un milione di token è quello del lancio di Opus 4.6, il 5 febbraio 2026, sulla prova MRCR v2: 76% per Opus 4.6, 18,5% per Sonnet 4.5. Anche il modello di punta di quel lancio, a quella lunghezza, sbaglia un caso su quattro.
I 78mila token di partenza sono in buona parte il mio company brain: regole aziendali, istruzioni di progetto e memoria che Claude carica a ogni sessione. Anche le istruzioni permanenti occupano contesto. Per questo Anthropic consiglia di tenere ogni CLAUDE.md sotto le 200 righe: quello che Claude legge sempre deve essere corto.
I modelli più leggeri cedono prima?
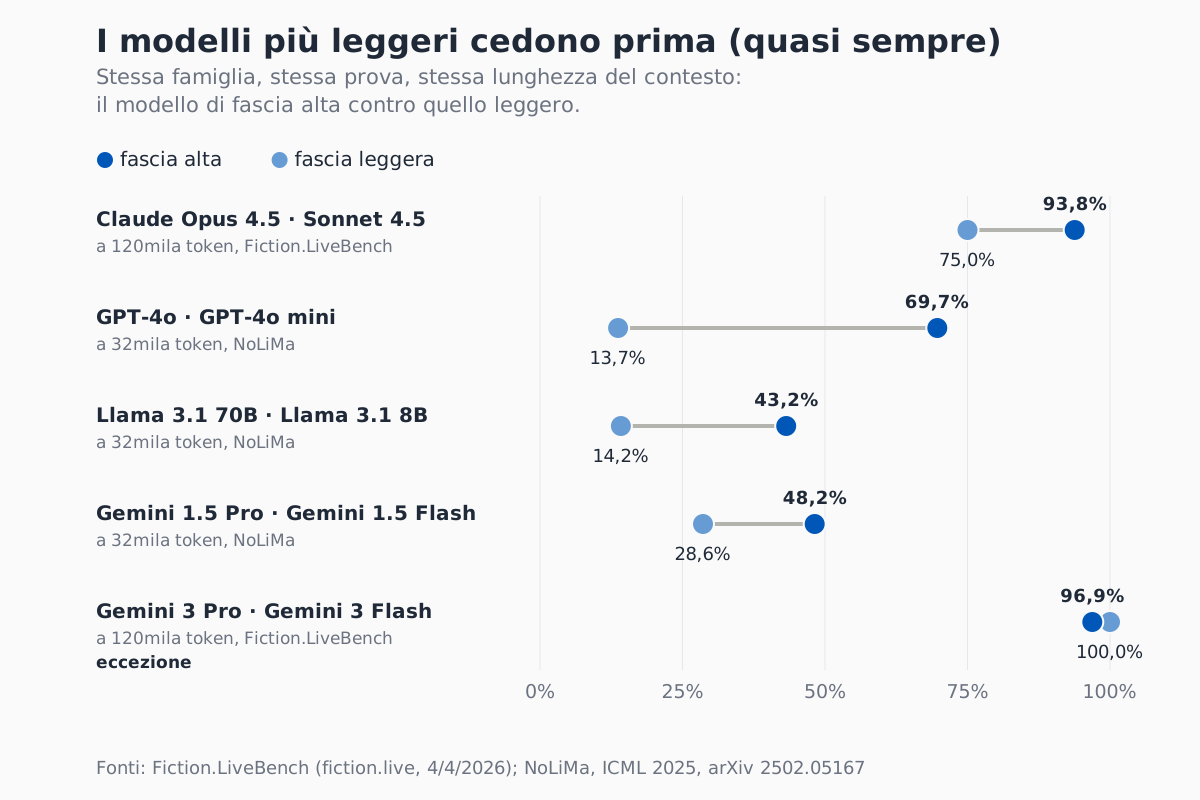
Quasi sempre sì. Il confronto che regge è dentro la stessa famiglia, con la stessa prova e la stessa lunghezza.
| Coppia | Prova e lunghezza | Fascia alta | Fascia leggera |
|---|---|---|---|
| Claude Opus 4.5 e Sonnet 4.5 | Fiction.LiveBench, 120mila token, aprile 2026 | 93,8% | 75,0% |
| GPT-4o e GPT-4o mini | NoLiMa, 32mila token, 2025 | 69,7% | 13,7% |
| Llama 3.1 70B e 8B | NoLiMa, 32mila token, 2025 | 43,2% | 14,2% |
| Gemini 1.5 Pro e Flash | NoLiMa, 32mila token, 2025 | 48,2% | 28,6% |
| Gemini 3 Pro e Flash | Fiction.LiveBench, 120mila token, aprile 2026 | 96,9% | 100% |
Per Claude il confronto giusto è fra Opus 4.5 e Sonnet 4.5, che sono della stessa generazione: a 120mila token Opus 4.5 ha lo stesso 93,8% di Opus 4.6, Sonnet 4.5 si ferma al 75%. L'eccezione c'è: su Fiction.LiveBench Gemini 3 Flash tiene il 100% a 120mila token, poco sopra il Pro. E Anthropic non pubblica le dimensioni dei suoi modelli: quello che si può dire è che le fasce leggere cedono prima, non che conti solo la taglia.
La regola pratica che ne tiro fuori: per un lavoro lungo su tanto materiale si usa la fascia alta, la fascia leggera va benissimo per compiti corti e mirati, dove il contesto resta piccolo. È anche il modo giusto di usare i subagenti di Claude Code: un compito circoscritto, un contesto pulito, e se basta un modello più leggero.
Perché allegare un file a Claude peggiora le risposte?
Perché un PDF o un documento allegato, quando Claude lo legge, non è un file: è testo trasformato in token, tutto dentro il contesto, anche le parti che non servono. Con un foglio di calcolo dipende dallo strumento, e ci arrivo in fondo alla sezione. E più la conversazione cresce, più è probabile che il modello perda proprio il pezzo importante di quel documento.
I numeri dicono quanto pesa. Secondo la documentazione di Anthropic sui PDF, ogni pagina costa da 1.500 a 3.000 token di testo, più l'immagine della pagina. Un contratto di 50 pagine vale da 75 a 150mila token di solo testo: da solo può arrivare ai 120mila token oltre i quali Fiction.LiveBench non misura più Claude, prima ancora di contare la conversazione.
E tutto quel contesto non aiuta. In Lost in the Middle (Liu e altri, Stanford, 2023, su modelli di quell'anno) i modelli usano bene l'informazione che sta all'inizio o alla fine del contesto e male quella in mezzo, e con 20 o 30 documenti, nel caso peggiore, rispondono peggio che senza documenti. Nello studio di Chroma, sulla prova LongMemEval, tutti i modelli rispondono meglio con circa 300 token mirati che con lo storico completo di circa 113mila.
Anthropic stessa indica l'alternativa. Nell'articolo sul context engineering descrive l'approccio "just in time": gli agenti tengono "lightweight identifiers (file paths, stored queries, web links, etc.)" e caricano i dati nel contesto con gli strumenti solo quando servono. Claude Code, scrive, analizza grandi basi dati con comandi come head e tail "without ever loading the full data objects into context".
La differenza si riassume così: allegare è consegnare una copia da leggere tutta, dare il percorso è dare accesso a un archivio da consultare. Cowork e Claude Code aprono la cartella, cercano, leggono solo le parti che servono, e il file resta quello aggiornato. Quasi tutti i clienti con cui lavoro, all'inizio, allegano il file alla chat. È la prima abitudine che correggo: invece di allegare, si dà a Claude il percorso della cartella.
Una precisazione su claude.ai. Con l'esecuzione del codice attiva ha un ambiente isolato e può analizzare un foglio di calcolo con del codice (Anthropic). Però lavora sulla copia che hai caricato, non sul file vivo della cartella condivisa, e la documentazione non dice quanta parte del file finisca nel contesto. Per le procedure che lavorano sempre sugli stessi file, un agente con accesso alla cartella resta la scelta migliore.
Quando conviene aprire una nuova chat?
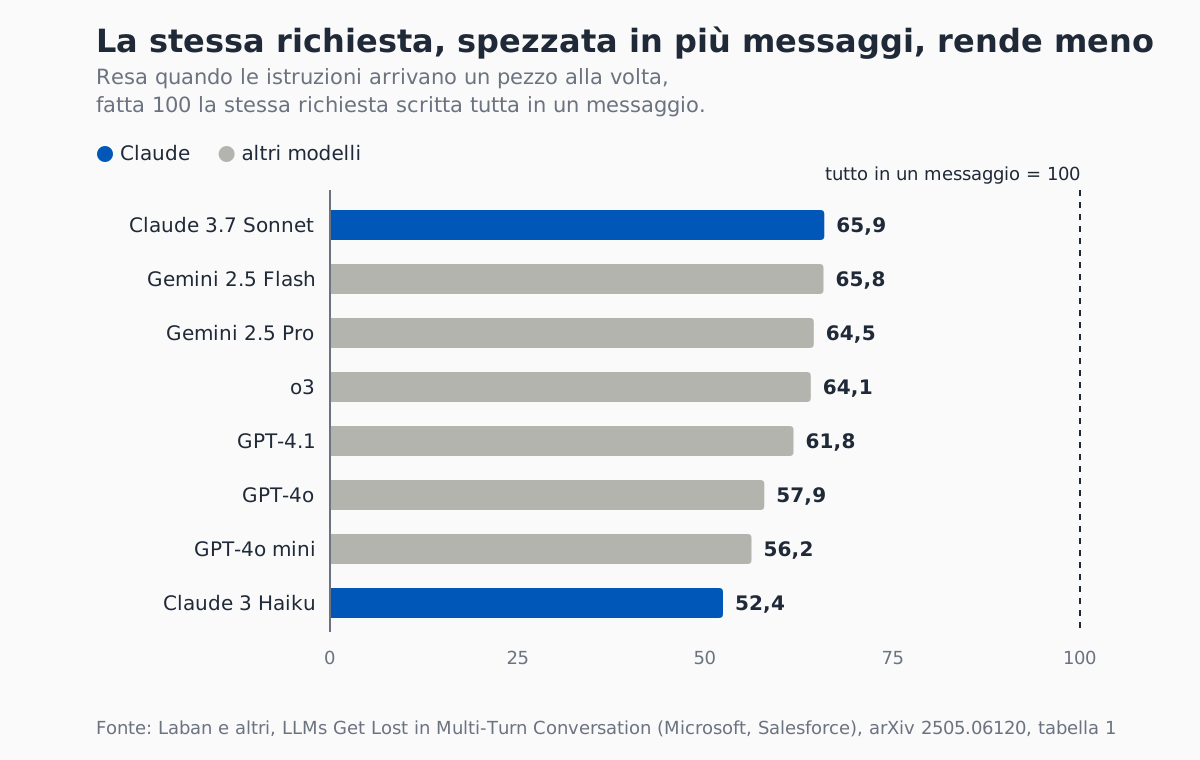
Lo studio di Philippe Laban e colleghi, di Microsoft e Salesforce, LLMs Get Lost in Multi-Turn Conversation (maggio 2025, oltre 200mila conversazioni simulate) ha confrontato la stessa richiesta scritta tutta in un messaggio con la stessa richiesta data un pezzo alla volta: in media la resa cala del 39%. Misura le istruzioni date a pezzi, non la lunghezza in sé, ma è proprio quello che succede in una chat che si allunga a forza di correzioni. La spiegazione degli autori è la frase che più somiglia a quello che vedo: "when LLMs take a wrong turn in a conversation, they get lost and do not recover". E il consiglio è esplicito: ricominciare una conversazione con le stesse informazioni "might yield significantly better outcomes".
Vicino al limite della finestra si aggiunge un secondo effetto: la compattazione. Quando in claude.ai compare l'avviso di compattazione della conversazione in corso per continuare a chattare, Claude sta riassumendo i messaggi vecchi per fare spazio.
La guida di Anthropic spiega che succede sui piani a pagamento con l'esecuzione del codice attiva, e che le conversazioni compattate consumano di più i limiti d'uso. In Claude Code la compattazione scatta da sola poco prima del limite, e la documentazione avverte che le istruzioni date all'inizio della conversazione possono andare perse. Riassumere vuol dire scegliere cosa tenere, e i dettagli sono la prima cosa che salta.
I segnali che uso io sono quattro:
- Cambi compito. Anche dentro lo stesso progetto: il lavoro di prima resta nel contesto e fa da distrattore.
- Due correzioni non sono bastate. È la regola delle best practice di Claude Code: dopo due correzioni fallite,
/cleare un prompt migliore invece di una terza. - Compare la compattazione. Da lì in poi lavori su un riassunto.
- Claude dimentica una regola data all'inizio. Se vale sempre, non va in un messaggio: va nelle istruzioni del progetto.
Prima di chiudere una chat lunga, una cosa conviene salvarla: chiedi a Claude di scrivere in poche righe le decisioni prese e il punto in cui sei, e incollale nella chat nuova. Riparti con le informazioni giuste e senza i tentativi sbagliati, che è quello che consiglia anche lo studio di Microsoft e Salesforce.
Come organizzare Claude in azienda: una procedura, una cartella
La chat è usa e getta, il progetto no. Claude separa la memoria per progetti e cartelle, ed è quello che conviene usare in azienda: ogni attività ricorrente che lavora sempre sugli stessi file merita il suo progetto, con le sue istruzioni, i suoi file e la sua memoria.
Ecco come funziona nei tre ambienti:
- claude.ai. Un progetto è uno spazio con istruzioni, file e chat propri, e ha una memoria separata: "Each project has its own memory", scrive la guida sulla memoria. Quando i file del progetto si avvicinano al limite del contesto, sui piani a pagamento Claude passa da solo alla ricerca nei documenti e la capacità sale fino a 10 volte.
- Cowork. Le istruzioni di cartella aggiungono il contesto del progetto quando scegli una cartella sul desktop, e Claude legge e scrive solo nelle cartelle che hai collegato. Anche qui i progetti hanno memoria propria: "What Claude learns in one project doesn't carry over to other projects."
- Claude Code. Il CLAUDE.md della cartella dà le regole, e la memoria automatica è una per repository: all'avvio di ogni sessione Claude carica le prime 200 righe del suo indice. Come strutturare le cartelle lo racconto nella guida ai progetti di Claude Code.
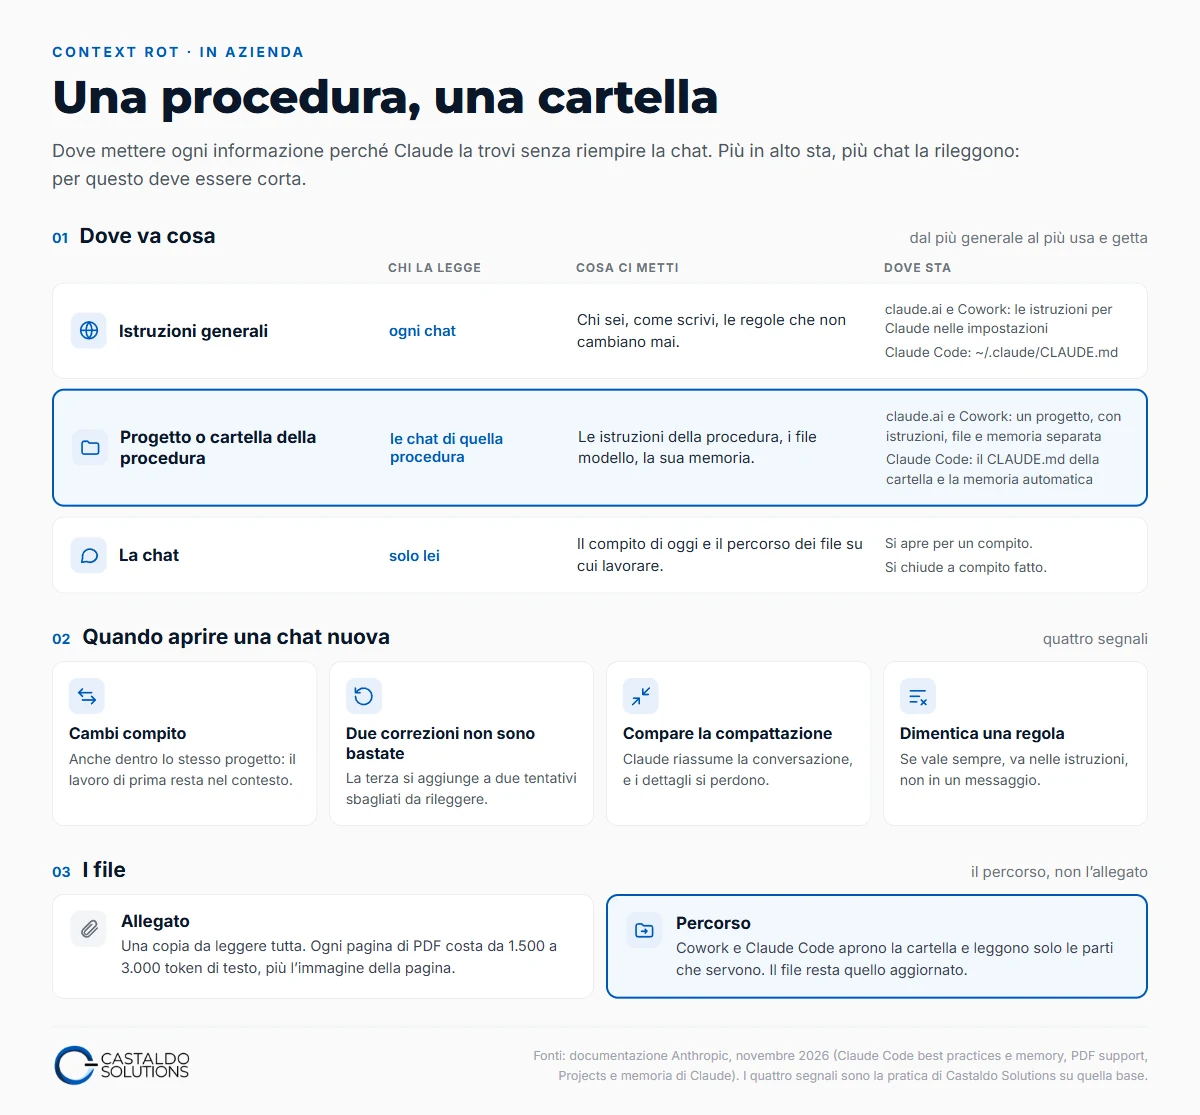
Io faccio così. All'8 novembre 2026, su uno dei miei PC, ci sono 42 cartelle di progetto con una memoria propria, 362 note in tutto: ogni cliente e ogni lavoro ricorrente ha la sua, e quello che Claude impara in una non sporca le altre. Le procedure ripetitive seguono la stessa regola: le offerte, i verbali delle riunioni, il rimborso chilometrico hanno le loro istruzioni scritte una volta, in una skill o nelle istruzioni del progetto. La chat dice solo cosa fare oggi e dove sono i file, e a lavoro finito si chiude.
Se vuoi partire da una cosa sola, parti dagli allegati. La prossima volta che stai per trascinare un Excel in chat, mettilo in una cartella e dai a Cowork il percorso.
Domande frequenti
Claude ricorda le chat precedenti?
Sì, se la memoria è attiva. Claude salva in memoria argomenti singoli mentre parli, non riassunti di intere conversazioni, e ogni progetto ha una memoria separata: quello che impara in un progetto non passa agli altri. Sui piani a pagamento può anche cercare nelle chat passate, e le chat in incognito non vengono salvate. In Claude Code la memoria sta nei file: il CLAUDE.md della cartella e la memoria automatica del repository, che resta sul computer dove lavori.
Cosa succede quando Claude compatta la conversazione?
Quando una chat si avvicina al limite della finestra di contesto, Claude riassume i messaggi più vecchi per continuare. In claude.ai succede sui piani a pagamento con l'esecuzione del codice attiva, e una conversazione compattata consuma di più i limiti d'uso. Il riassunto conserva il filo ma perde dettagli, e la documentazione di Claude Code avverte che le istruzioni date all'inizio possono andare perse. Le regole che devono valere sempre vanno quindi nelle istruzioni del progetto o nel CLAUDE.md.
La finestra da 1 milione di token risolve il context rot?
No. Una finestra più grande aumenta quanto testo Claude può tenere, non quanto bene lo usa. Anthropic lo scrive nella sua documentazione: più contesto non è automaticamente meglio, perché accuratezza e richiamo calano al crescere dei token. Sulla prova MRCR v2 a un milione di token, nel lancio del 5 febbraio 2026, Claude Opus 4.6 ottiene il 76% e Sonnet 4.5 il 18,5%. La finestra grande serve, ma il contesto va comunque tenuto pulito.