Come funziona la memoria di Claude e degli agenti (e quanto costa ricordare troppo)
Claude Code ricorda in due modi: le istruzioni che scrivi tu nei CLAUDE.md e la memoria automatica che scrive da solo, una per repository. Tutto quello che carica all'avvio si paga a ogni sessione, e nel progetto del nostro sito la memoria era la voce più pesante. Come funziona, come si condivide fra progetti, le opzioni dalla più semplice al company brain, e come l'abbiamo dimezzata con le prove prima e dopo.
La memoria di Claude Code è fatta di due parti: le istruzioni che scrivi tu nei file CLAUDE.md e le note che Claude scrive da solo nella memoria automatica, una cartella per ogni repository. All'avvio carica i CLAUDE.md per intero e l'indice della memoria, il resto lo legge quando serve. Tutto quello che carica, lo paghi a ogni sessione.
In pratica: tieni corto quello che si carica sempre, sposta i dettagli dove si aprono solo quando servono, e prima di aggiungere una memoria esterna metti in ordine quella che hai.
Lo dico con i numeri. Su uno dei miei PC una sessione di Claude Code parte, in mediana, da 78.496 token prima ancora del primo messaggio, e nel progetto del nostro sito la voce più pesante di quel conto era la memoria: 29,4mila token, più di metà dei quali in un file solo. In questo articolo spiego come funziona la memoria di Claude e degli agenti, quanto costa e quali opzioni ci sono per potenziarla, dalla più pratica alla più complessa. Poi racconto come l'abbiamo dimezzata, con le prove fatte prima e dopo.
Come funziona la memoria di Claude Code?
Ogni sessione di Claude Code parte con il contesto vuoto: il modello non ricorda la conversazione di ieri. A portare la conoscenza da una sessione all'altra ci sono due meccanismi, che la documentazione di Anthropic distingue così:
| CLAUDE.md | Memoria automatica | |
|---|---|---|
| Chi la scrive | Tu | Claude |
| Cosa contiene | Istruzioni e regole | Correzioni, preferenze, fatti che il codice non dice |
| Dove sta | Nel progetto e in ~/.claude/ |
In ~/.claude/projects/<progetto>/memory/ |
| Cosa si carica all'avvio | Ogni file, per intero | Le prime 200 righe o 25KB dell'indice MEMORY.md |
CLAUDE.md: le istruzioni che scrivi tu
Il CLAUDE.md è il file in cui scrivi quello che altrimenti ripeteresti in ogni chat: i comandi, le convenzioni, i file da non toccare. Claude Code lo cerca a più livelli: il file dell'organizzazione gestito dall'IT, il tuo personale in ~/.claude/CLAUDE.md, quello del progetto in ./CLAUDE.md o ./.claude/CLAUDE.md, più un CLAUDE.local.md per le note che non vanno su git. Carica quelli della cartella in cui lo lanci e di tutte quelle sopra; i CLAUDE.md delle sottocartelle li legge solo quando lavora lì dentro. Come si scrive bene lo racconto nella guida a CLAUDE.md.
Due dettagli contano per il costo. Le regole in .claude/rules/ con un campo paths si caricano solo quando Claude apre un file del loro perimetro. Gli import con @percorso invece aiutano a ordinare un file lungo, ma secondo la documentazione "don't reduce its context cost": il file importato si carica insieme a quello che lo importa.
La memoria automatica: le note che scrive Claude
La memoria automatica è la memoria persistente che Claude riempie da solo mentre lavori: le tue correzioni, le preferenze, i fatti del progetto che non si ricavano dal codice. Ogni nota è un file markdown con un tipo (user, feedback, project o reference), e un indice, MEMORY.md, tiene una riga per nota. All'avvio Claude carica solo l'indice, fino a 200 righe o 25KB, e apre le note quando gli servono. La documentazione aggiunge un dettaglio utile: Claude non salva quello che può ricavare dal codice né "anything your CLAUDE.md files already say".
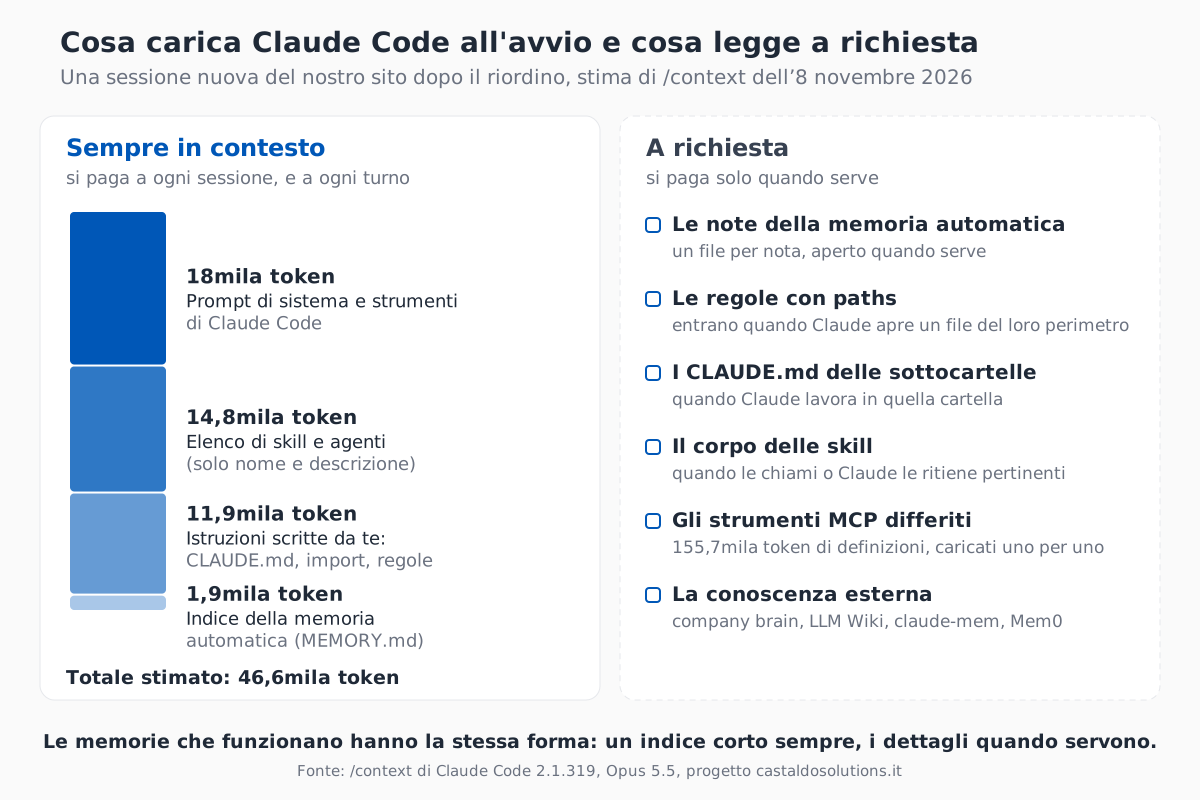
La regola vale per tutto: quello che sta a sinistra si paga a ogni sessione, quello che sta a destra solo quando serve. Gli strumenti MCP sono l'esempio più chiaro: nel nostro caso le loro definizioni valgono 155,7mila token, ma Claude Code le carica una per una, quando servono.
Claude ricorda le cose fra un progetto e l'altro?
No, ed è voluto. La memoria automatica sta in ~/.claude/projects/<progetto>/memory/, e il progetto lo decide il repository git: secondo la documentazione "all worktrees and subdirectories within the same repo share one auto memory directory", e fuori da git vale la cartella. Avevo sempre pensato che Claude segmentasse la memoria per cartella di lavoro: è quasi vero, la segmenta per repository.
Questo ha due conseguenze pratiche. La prima: quello che Claude impara in un progetto, negli altri non lo vede. La seconda: la memoria non viaggia, perché è "machine-local". Io uso Claude Code su più di un PC, e quello che impara su uno, sull'altro non c'è.
Ce ne siamo accorti con un caso concreto. La cartella di un corso di formazione per un cliente è stata spostata dentro un altro repository. Da quel momento le sessioni nel nuovo repository usavano la sua memoria, che era vuota, mentre le due note sul corso (calendario, formatori, scelte didattiche) restavano in due cartelle orfane, identiche, dove nessuna sessione le avrebbe più lette.
In claude.ai e in Cowork il principio è lo stesso: la memoria è separata per progetto. Anthropic lo scrive nell'annuncio della memoria, "Claude creates a separate memory for each project", e nell'articolo sul context rot spiego perché conviene dare una cartella a ogni procedura.
Come si condivide la memoria fra progetti diversi?
Quando una cosa vale ovunque, va portata fuori dal singolo progetto. Le strade, dalla più semplice:
- Il CLAUDE.md utente,
~/.claude/CLAUDE.md: vale per tutti i progetti, ma solo su quel PC. - Le regole utente in
~/.claude/rules/: si caricano in ogni progetto. Se la cartella è un collegamento a un repository git, le stesse regole arrivano su ogni PC con ungit pull. In Cowork però le regole collegate a una cartella esterna non si caricano. - Un import di un file condiviso, con
@percorso/file.md: è così che il nostro CLAUDE.md utente carica in ogni sessione il CORE del company brain. - Le cartelle aggiuntive: con
--add-dirClaude lavora anche in un'altra cartella, e con la variabileCLAUDE_CODE_ADDITIONAL_DIRECTORIES_CLAUDE_MD=1ne carica anche i CLAUDE.md. - Una memoria automatica in comune: l'impostazione
autoMemoryDirectorysposta la cartella della memoria, quindi più repository dello stesso cliente possono scrivere nella stessa. - La memoria dei subagenti: il campo
memorynella definizione di un agente, con lo scopeuser,projectolocal, gli dà una memoria propria, che conuservale in tutti i progetti. Dei subagenti e di quanto consumano parlo nell'articolo sui subagenti di Claude Code.
Il rischio opposto è una lezione che vale ovunque salvata nel posto sbagliato. Nell'audit dell'8 novembre 2026, sulle 367 note di memoria del mio PC, "fai sempre commit e push" stava in sette progetti diversi, e la regola su quale modello usare per i subagenti in nove, in tre versioni che si contraddicevano. Ogni sessione applicava la versione del progetto in cui girava. Le abbiamo portate in una sola regola utente: 824 token, caricati ovunque.
Quanto costa la memoria di Claude in token?
Ho misurato le 234 sessioni di Claude Code degli ultimi 90 giorni su uno dei miei PC, dai transcript locali, che registrano i token di ogni richiesta: il primo turno parte da una mediana di 78.496 token, prima ancora di scrivere il primo messaggio. Nel progetto del sito la mediana è di 85mila, e la sessione dell'8 novembre è partita da 91mila.
Per vedere di cosa è fatto quel conto basta un comando, /context all. In una sessione nuova del sito, prima del riordino, ha stimato 62,6mila token: 18mila di prompt di sistema e strumenti, MCP compresi, 14,8mila di elenchi di skill e agenti, 29,4mila di file di memoria e il resto in messaggi della sessione. Di questi, 17,9mila erano un file solo, tech.md, le istruzioni tecniche del sito: 595 righe caricate in ogni sessione, anche in quelle in cui si scriveva un articolo e non si toccava il codice.
Negli altri progetti il quadro si ripete, e dice dove sta il problema. Su otto progetti misurati con /context, il CLAUDE.md di progetto va da 27 token a 51.300 in un progetto cliente, mentre l'indice della memoria automatica non supera mai i 3.400, perché ha un tetto di 200 righe. La memoria che pesa di più non è quella che scrive Claude: è quella che scriviamo noi e non potiamo mai.
Il prezzo si paga in due modi:
- In token, a ogni sessione. Il contesto di partenza si scrive in cache alla prima richiesta e si rilegge a ogni turno. Per una domanda da una riga, una sessione nuova del sito è costata 0,47 dollari a prezzi API secondo la stima di Claude Code, quasi tutti per scrivere in cache quei token. Con un abbonamento non paghi in dollari, ma consumi i limiti d'uso.
- In attenzione. Anthropic lo scrive nella documentazione: i file oltre le 200 righe "consume more context and reduce adherence". Lo studio IFScale di Distyl AI, del luglio 2025, lo misura sui modelli di allora: Claude Opus 4 rispetta il 100% di 50 istruzioni date insieme, il 94,6% di 100 e il 44,6% di 500, e anche i modelli migliori, a 500 istruzioni, si fermano al 68%.
Memoria semplice o potenziata: quali opzioni ci sono?
Le opzioni, dalla più pratica alla più complessa:
| Opzione | Dove sta | Cosa si carica | Quando conviene |
|---|---|---|---|
| Memoria delle chat (claude.ai, Cowork) | Nel tuo account, per progetto | La gestisce Claude | Lavori dall'app e non vuoi scrivere file |
| CLAUDE.md | Nel progetto | Tutto, a ogni sessione | Le regole che valgono sempre |
| Memoria automatica | ~/.claude/projects/ |
L'indice, le note a richiesta | Correzioni e preferenze, senza fatica |
Regole con paths e skill |
.claude/rules/, .claude/skills/ |
Solo quando servono | Dettagli e procedure lunghe |
| LLM Wiki di Karpathy | Un vault Obsidian | L'indice, poi le pagine | Una base di conoscenza su un tema, compilata dalle fonti |
| Strumenti esterni (claude-mem, Mem0) | Database e vettori | Quello che hook o MCP iniettano | Catturare in automatico cosa fa l'agente |
| Company brain | Un repository git | Un file sempre, il resto a richiesta | La conoscenza di un'azienda, condivisa da più progetti e agenti |
Cos'è la LLM Wiki di Karpathy?
La LLM Wiki è un metodo che Andrej Karpathy ha descritto ad aprile 2026 in un gist: invece di cercare nei documenti a ogni domanda, come fa un RAG, l'agente compila le fonti in pagine markdown collegate e le tiene aggiornate. Ha tre strati (le fonti grezze, che non si toccano; la wiki, che scrive l'agente; uno schema, che per Claude Code è un CLAUDE.md) e tre operazioni: ingest, query e lint.
Karpathy spiega così la differenza: in un RAG "the LLM is rediscovering knowledge from scratch on every question", nella wiki "The knowledge is compiled once and then kept current". Obsidian fa da visore: "Obsidian is the IDE; the LLM is the programmer; the wiki is the codebase". Secondo lui il metodo regge "at moderate scale (~100 sources, ~hundreds of pages)".
A maggio 2026 l'ho costruita sui materiali di Castaldo Solutions, con due skill, una per compilare e una per il lint: 39 sorgenti sono diventate 61 pagine e 695 collegamenti. La cosa più utile l'ha fatta da sola: ha trovato le contraddizioni nei nostri materiali, come la sede legale scritta a Milano in un documento e a Pavia in un altro, o i pillar che in una pagina erano tre e in un'altra quattro. Era un esperimento: alla fine ho scelto la struttura del company brain, più complessa, ma mi serviva capire i meccanismi di funzionamento, e ne è valsa la pena.
Gli strumenti esterni: claude-mem, Mem0 e gli altri
Fuori da Claude Code c'è un mercato di memorie per agenti. Quello con più stelle su GitHub è claude-mem, 114.818 all'8 novembre 2026: un plugin che con degli hook osserva quello che l'agente fa durante la sessione, lo comprime e lo rimette in contesto nelle sessioni successive. Mem0, 68.640 stelle, è uno strato di memoria con ricerca semantica, usabile da qualsiasi agente; Basic Memory tiene la memoria in file markdown che l'agente interroga via MCP.
Fanno tutti la stessa scommessa: catturare di più, in automatico. Ha senso quando l'agente non ha una memoria propria. Con Claude Code una memoria automatica c'è già, e il rischio diventa il contrario: ricordare troppo. Il nostro company brain ha preso da questi strumenti le idee che funzionano, senza aggiungere un database.
Il company brain: la memoria di un'azienda
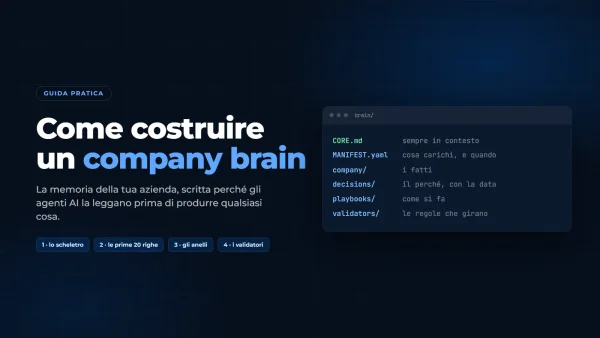
Il company brain è la nostra memoria aziendale: un repository git di file markdown che leggono tutti i progetti e tutti gli agenti. È l'opzione più complessa, ed è fatto degli stessi pezzi delle altre:
- un indice corto sempre, i dettagli a richiesta, come
MEMORY.mde l'indice della wiki di Karpathy: un solo file, il CORE, sta sempre in contesto, e una mappa dice quale altro file aprire e quando; - il lint della wiki: a ogni commit tre controlli verificano lo stile, i numeri che non devono divergere fra un file e l'altro e la coerenza della mappa;
- la scadenza dei fatti: ogni file ha una data di verifica, e all'avvio di ogni sessione un hook elenca quelli scaduti, da trattare come ipotesi;
- la cattura automatica, come gli hook di claude-mem: a fine sessione un hook raccoglie le frasi con cui ho corretto l'agente e le manda al nostro agente PM, che la mattina dopo mi propone dove scriverle.
Come funziona la memoria di un agente Claude con le API?
Chi sviluppa un agente proprio con le API di Anthropic ha due strumenti di memoria. Il memory tool dà a Claude una cartella di file da leggere e scrivere, che però vive nella tua applicazione: "Claude requests file operations, and your application runs them". Nei Managed Agents, ancora in beta, la memoria è uno store di documenti montato nel sandbox dell'agente, e la documentazione dà un consiglio che vale per qualsiasi memoria: "Structure memory as many small focused files, not a few large ones."
Come abbiamo dimezzato la memoria di partenza?
L'8 novembre 2026 abbiamo applicato il metodo a noi stessi, nel progetto del sito, con tre interventi:
tech.mddiviso. Le sezioni lunghe (blog, CSS, performance, provenienza dei lead, navbar, dati strutturati, server) sono diventate sette regole conpaths, che si caricano quando Claude apre i file a cui servono. Nel file sempre caricato sono rimaste 102 righe su 595, con una mappa delle regole.- La memoria automatica riordinata. Nel sito tolte 13 note che ripetevano il CORE, una regola o un file del brain, e riscritte 4: l'indice è passato da 42 a 29 voci, ognuna sotto i 150 caratteri. Negli altri progetti tolti 18 doppioni puri, e le note del corso rimaste orfane sono tornate dove le sessioni le leggono.
- Le lezioni comuni in un posto solo: la regola utente di cui parlavo sopra.
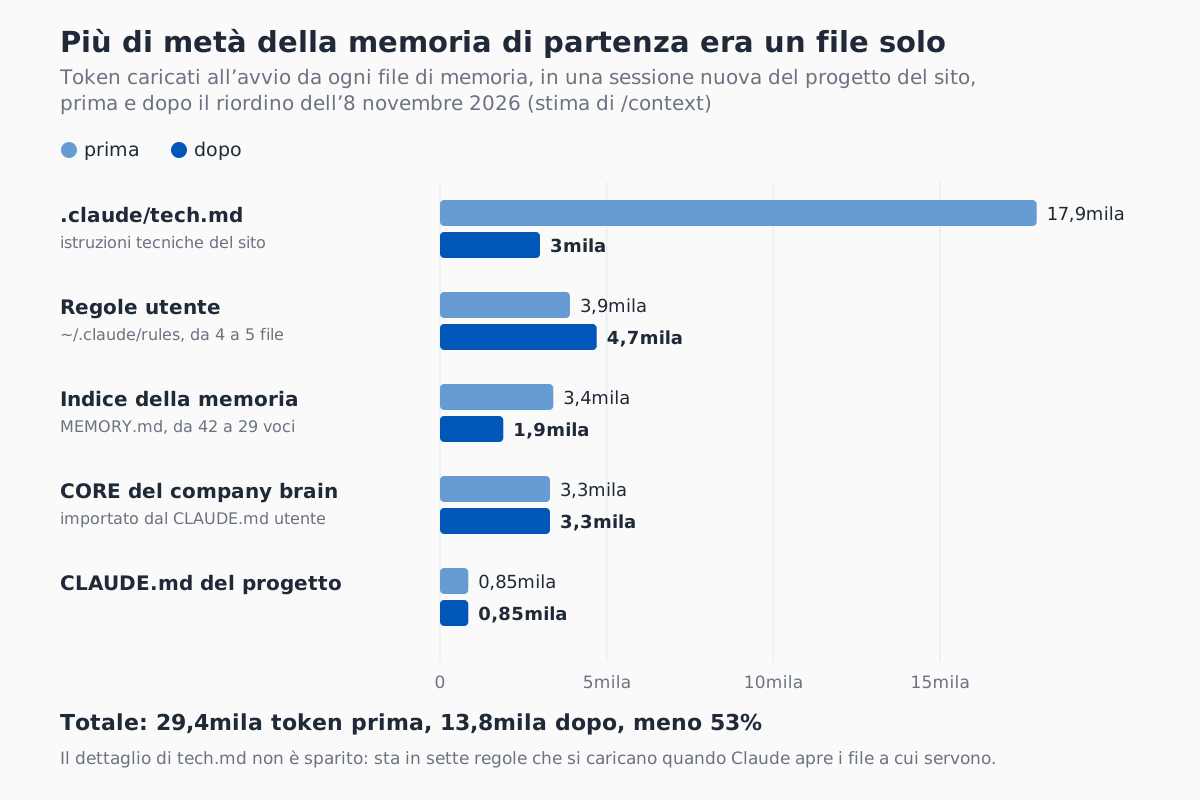
| Misura, progetto del sito | Prima | Dopo |
|---|---|---|
File di memoria all'avvio, stima di /context |
29,4mila token | 13,8mila token |
tech.md sempre caricato |
595 righe, 17,9mila token | 102 righe, 3mila token |
| Primo turno reale di una sessione nuova | 85.013 token | 69.670 token |
Il primo turno reale, misurato dopo la divisione di tech.md e prima del riordino dell'indice, è sceso del 18%: i file di memoria si sono dimezzati, il resto del contesto di partenza no.
Poi la prova che conta, quella sulla qualità. Ho fatto a una sessione nuova, prima e dopo, la stessa domanda: qual è il comando esatto per svuotare la cache del blog in produzione? La risposta sta in una delle regole spostate, e con la versione 2 del CMS è cambiata. Prima Claude rispondeva giusto perché aveva tutto tech.md in contesto. Dopo ha risposto giusto in entrambi i modi in cui l'ho provato: senza aiuti ha letto la mappa e ha aperto da solo la regola del blog; dopo aver aperto un articolo, la regola gli è arrivata in contesto da sola.
Una cosa l'abbiamo imparata strada facendo: non ogni doppione va tolto. Una nota che ripete un file del brain resta se quel file si apre solo su richiesta e la nota protegge da un errore. Il divieto di mettere in pipe un comando sul server, per esempio, sta nel brain, ma la nota nella memoria del sito resta: quei comandi Claude li lancia anche quando nessuno nomina il server.
Come rendere efficiente la memoria di Claude: sei passi
- Misura. In una sessione nuova lancia
/context alle leggi la voce "Memory files", file per file. Se la lanci da terminale conclaude -p "/context all"su Windows con Git Bash, aggiungiMSYS_NO_PATHCONV=1, altrimenti la barra iniziale diventa un percorso. - Accorcia quello che si carica sempre. Ogni CLAUDE.md sotto le 200 righe; i dettagli che servono solo a una parte del codice in
.claude/rules/conpaths; le procedure lunghe in una skill; nel file principale una mappa con una riga per regola, così Claude sa cosa aprire. - Riordina la memoria automatica con le quattro fasi che usa Anthropic, descritte nella sezione qui sotto: guarda cosa c'è, cerca i fatti superati, unisci i doppioni e tieni l'indice a una riga per nota.
- Porta in alto le lezioni che valgono ovunque, in una regola utente in
~/.claude/rules/, e togli le copie dai singoli progetti. - Controlla dove punta la memoria quando sposti una cartella o un repository: le note restano dove erano, e la sessione nuova parte vuota.
- Prova prima e dopo. Rilancia
/context alle fai a una sessione nuova una domanda la cui risposta hai spostato: deve rispondere giusto comunque.
Per mantenerla nel tempo ci sono strumenti già pronti. /memory apre la cartella della memoria e permette di spegnerla o accenderla. /doctor prompt-audit, che secondo la documentazione richiede Claude Code 2.1.283 o successivo, cerca nei tuoi file istruzioni superate o in conflitto. Il plugin ufficiale claude-md-management aggiorna il CLAUDE.md con quello che hai imparato in sessione. E se un'istruzione deve valere sempre, senza eccezioni, non è memoria: è un hook.
Claude Code consolida la memoria da solo?
Non ancora, almeno non in modo documentato. Nel codice di Claude Code 2.1.319, la versione installata sul mio PC l'8 novembre 2026, c'è già un'impostazione, autoDreamEnabled, descritta così: "Enable background memory consolidation (auto-dream)". Lì scatta dopo almeno 24 ore e 5 sessioni dall'ultimo consolidamento, ma la documentazione non la cita, e da noi non è ancora attiva.
Il prompt che usa si legge nel programma, con il titolo "Dream: Memory Consolidation", e lavora in quattro fasi: orientarsi su cosa c'è già nella memoria; raccogliere i segnali recenti, cioè i fatti che il codice ha smentito e qualche ricerca mirata nei transcript; consolidare, unendo invece di duplicare, trasformando le date relative in assolute e correggendo alla fonte i fatti smentiti; potare l'indice, con una riga sotto i 150 caratteri per nota. Finché non arriva per tutti, si fa a mano: è quello che abbiamo fatto noi.
Domande frequenti
Dove salva la memoria Claude Code?
La memoria automatica sta in ~/.claude/projects/<progetto>/memory/, una cartella per repository git: sottocartelle e worktree dello stesso repository la condividono. Dentro ci sono l'indice MEMORY.md, di cui Claude carica all'avvio le prime 200 righe o 25KB, e un file per ogni nota, letto quando serve. Le istruzioni scritte da te invece stanno nei CLAUDE.md, nel progetto e in ~/.claude/CLAUDE.md, e si caricano per intero.
Come si disattiva la memoria automatica di Claude Code?
Dal comando /memory, con l'interruttore della memoria automatica, che salva autoMemoryEnabled nelle impostazioni utente. Per un solo progetto si mette "autoMemoryEnabled": false nelle impostazioni di quel progetto, e con una variabile d'ambiente si usa CLAUDE_CODE_DISABLE_AUTO_MEMORY=1. I CLAUDE.md restano attivi: si spengono solo le note che Claude scrive da solo.
La memoria di Claude Code si sincronizza fra computer diversi?
No. La documentazione di Anthropic la definisce "machine-local": le note non passano da un computer all'altro né agli ambienti cloud. Per avere le stesse regole su più PC, tienile in un repository git e collegale in ~/.claude/rules/, oppure importale nel CLAUDE.md utente. Noi facciamo così con il CORE del company brain e con le regole comuni.
Se vuoi partire da una cosa sola, parti dalla misura: apri una sessione nuova nel progetto che usi di più e lancia /context all. Se la voce più grande è un file che hai scritto tu, sai già da dove cominciare.